
外观
Personal Agent 是大厂的,但“我”应该属于自己
前几天写了篇《Personal Agent 火了,新酿还是旧酒?》。
当时有一个核心判断:
过去的 Agent,大多还是围绕 Task 展开的。
你告诉 AI 一个任务,它负责理解目标、规划步骤、调用工具,然后完成任务。
但 Personal Agent 正在发生一个重要变化:
AI 的中心开始从 Task 逐渐转向 Person。
它不只是知道“这次要做什么”,而是开始尝试理解:
- 你是谁。
- 你正在做什么。
- 你的长期目标是什么。
- 你喜欢什么样的输出方式。
- 你通常如何做判断。
- 你希望 AI 如何与你协作。
这也是为什么越来越多 AI 产品开始强调 Memory。
但继续往下想,我发现这里还有一个很现实的问题:
一个 AI 到底需要多久,才能真正认识你?
Personal AI 越来越懂你,但这个过程其实很慢
现在主流 AI 基本都有 Memory 能力。
长期使用以后,体验确实会越来越好。
它会逐渐知道:
- 你喜欢什么表达方式。
- 你习惯如何组织工作。
- 你有哪些长期项目。
- 哪些回答方式你不喜欢。
- 甚至知道一些你的决策习惯。
但这个过程,本质上是一个长期积累过程。
你需要不断和 AI 交流。
不断纠正它:
这个方向不是我想要的。 不要做这么复杂。 先验证核心价值。 这里应该直接推进。 这个事情需要先确认。
经过大量真实交互以后,AI 才逐渐形成对你的理解。
但问题是:
如果换一个新的 AI 呢?
换一个新的模型。
换一个新的 Agent。
很多东西又需要重新开始。
于是我开始思考:
有没有一种方式,可以把一个 AI 原本需要长期相处才能形成的理解,提前快速建立出来?
也就是:
能不能通过一次系统化的交流,让一个新的 AI 快速获得一份关于我的初始 Memory?
我暂时把这个想法称为:
Personal Twin。
Personal Twin,本质上是 Memory 的快速冷启动
严格来说,Personal Twin 并不是 Memory 之外创造了一个新的东西。
它更像是:
通过结构化访谈,快速生成一份可用 Memory 初版的方法。
正常情况下,AI 对用户的理解是这样形成的:
- 多次对话
- 不断反馈
- 不断修正
- 逐渐形成 Memory
而 Personal Twin 想尝试的是:
- 集中结构化访谈
- 提炼模型
- 生成初版 Memory
- 交给 Agent 使用
它不是为了替代长期 Memory。
也不是为了创造一个永远不变的“数字分身”。
它只是希望降低一个新的 AI 认识你的成本。
换句话说:
让一个刚认识你的 AI,快速拥有一个接近长期使用后的起点。
Personal Twin 的核心,是 Decision Model
首先需要声明,此决策模型不是 Jev 等决策模型,或者说,当前还没有使用它们。
如果要生成一份关于用户的 Memory,最容易想到的是用户画像。
比如:
我是一个独立开发者。
喜欢简洁的内容。
喜欢极简设计。
做产品偏向 MVP。
不喜欢复杂方案。
这些信息当然有价值。
但继续思考会发现:
它们还不够。
因为真正影响 AI 输出的,往往不是:
你是什么样的人。而是:
你通常如何判断问题。比如:
- 速度和完整度冲突时,你怎么选择?
- 一个新技术出现时,你如何判断是否值得采用?
- 一个产品做到什么程度,你认为可以开始验证?
- 面对多个方案时,你更关注哪些因素?
- 什么时候 AI 可以直接推进?
- 什么时候必须先问你? 这些内容,比简单标签更接近一个人的工作方式。
举个简单例子。
如果问:
做产品时,你更重视速度还是完整度?有些人可能回答:
速度。但如果 AI 直接记录:
用户重视速度。这个结论其实并不准确。
继续追问:
最近一次因为速度和完整度做取舍是什么?可能会发现:
在产品验证阶段,希望快速推进。
但如果涉及:
- 数据模型;
- 安全;
- 基础架构;
- 高返工成本的问题;
又会更加谨慎。
所以更有价值的 Memory 应该是:
用户希望快速验证方向,但不会为了速度牺牲长期维护成本;对于高返工成本的问题,会提前投入时间验证。
前者只是一个标签。
后者才是一条可以帮助 AI 判断的规则。
所以我觉得,Personal Twin 最重要的部分,不是 Profile。
而是:
Decision Model。
它不是告诉 AI:
遇到某个问题,你一定选择什么答案。
而是告诉 AI:
当遇到类似问题时,这个人通常从哪些角度思考。
比如:
不是:
用户喜欢简单方案。而是:
用户倾向优先选择简单、可维护的方案;但如果简单方案会带来未来高成本重构,会提前投入时间验证。不是:
用户喜欢快速开发。而是:
用户倾向先形成完整闭环,再逐步扩展功能;不会因为未来可能增加需求,就提前引入复杂架构。换句话说:
Personal Twin 记录的不是:
What would I choose?而是:
How would I think about it?它提供的是:
判断框架,而不是固定答案。
最初的版本甚至不需要系统
想到这里以后,作为开发者,很自然会想到:
做一个完整系统。
- 访谈。
- 用户模型。
- Memory 管理。
- 版本控制。
- 自动更新。
- 跨 Agent 同步。
这些事情当然都可以做。
但按照 MVP 的思路,真正需要先验证的不是:
系统能不能实现。
而是:
通过结构化访谈生成的初版 Memory,到底有没有价值。
所以第一版很简单,就是一个 Skill。
没有数据库,没有 Web 产品,没有复杂工程。
通过和 ChatGPT 的多轮沟通,很快就完成了。
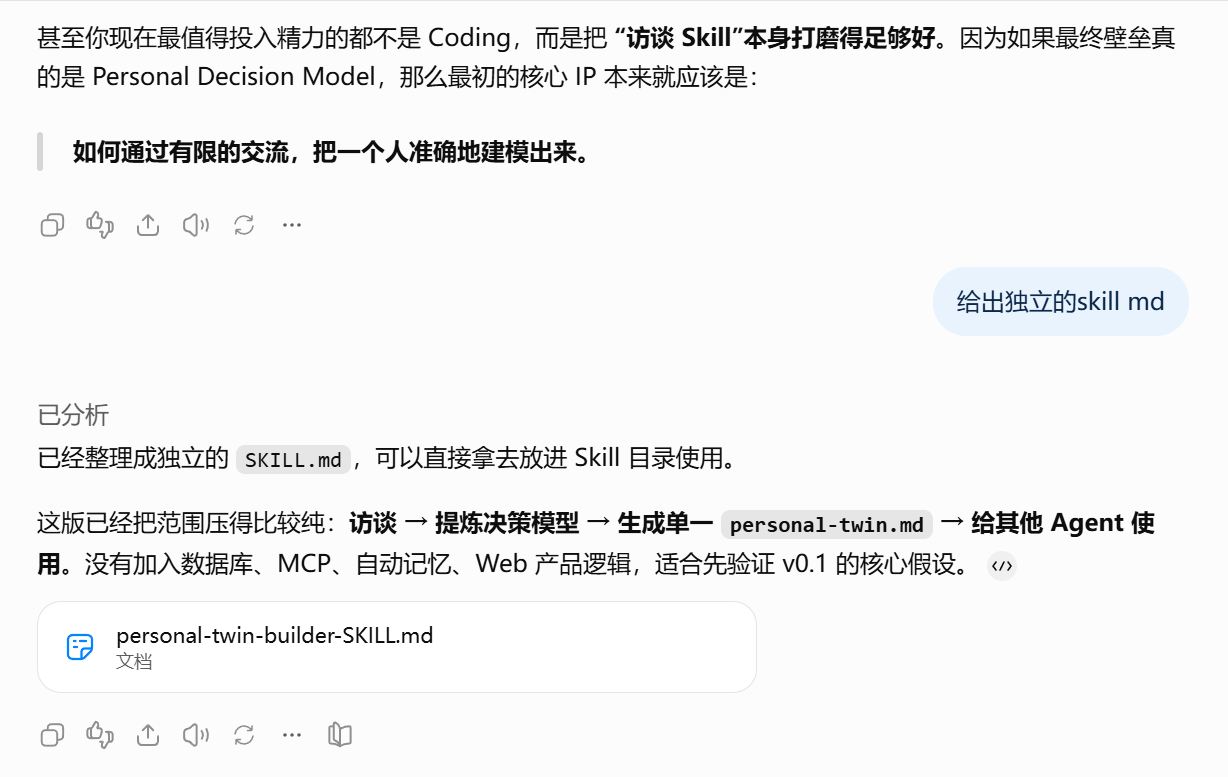
Skill 本身不是本文重点,我们就不再展开了,技能文件放到了 gitee 上,下一章节和文末都有链接,大家可以自取。
一次真实对比
为了验证效果,我找了一个真实的产品场景。
我最近有个想法:做一个 AI 截图工具。除了普通截图,还希望 AI 能理解截图内容,后续可以继续做一些处理。 帮我设计这个产品的方案。
对比方案的区别就是在开头是否增加:
请先将
personal-twin.md作为关于我的背景信息。
Personal Twin 生成
以下步骤都可以在你喜欢的 Agent 中完成,WorkBuddy、DeepSeek、豆包、ChatGPT 都可以。
原本我是打算在 WorkBuddy 中完成的,但 WorkBuddy 中的 Memory 有些多,相当于自带了部分 Personal Twin,因此最后的对比切换到用的比较少的豆包中完成了。
第一步,安装 Personal Twin Skill。
使用你喜欢的 Agent 安装 Skill,我使用了 WorkBuddy 安装,选择的 DeepSeek V4.1 Flash 模型。
Skill 源码地址:
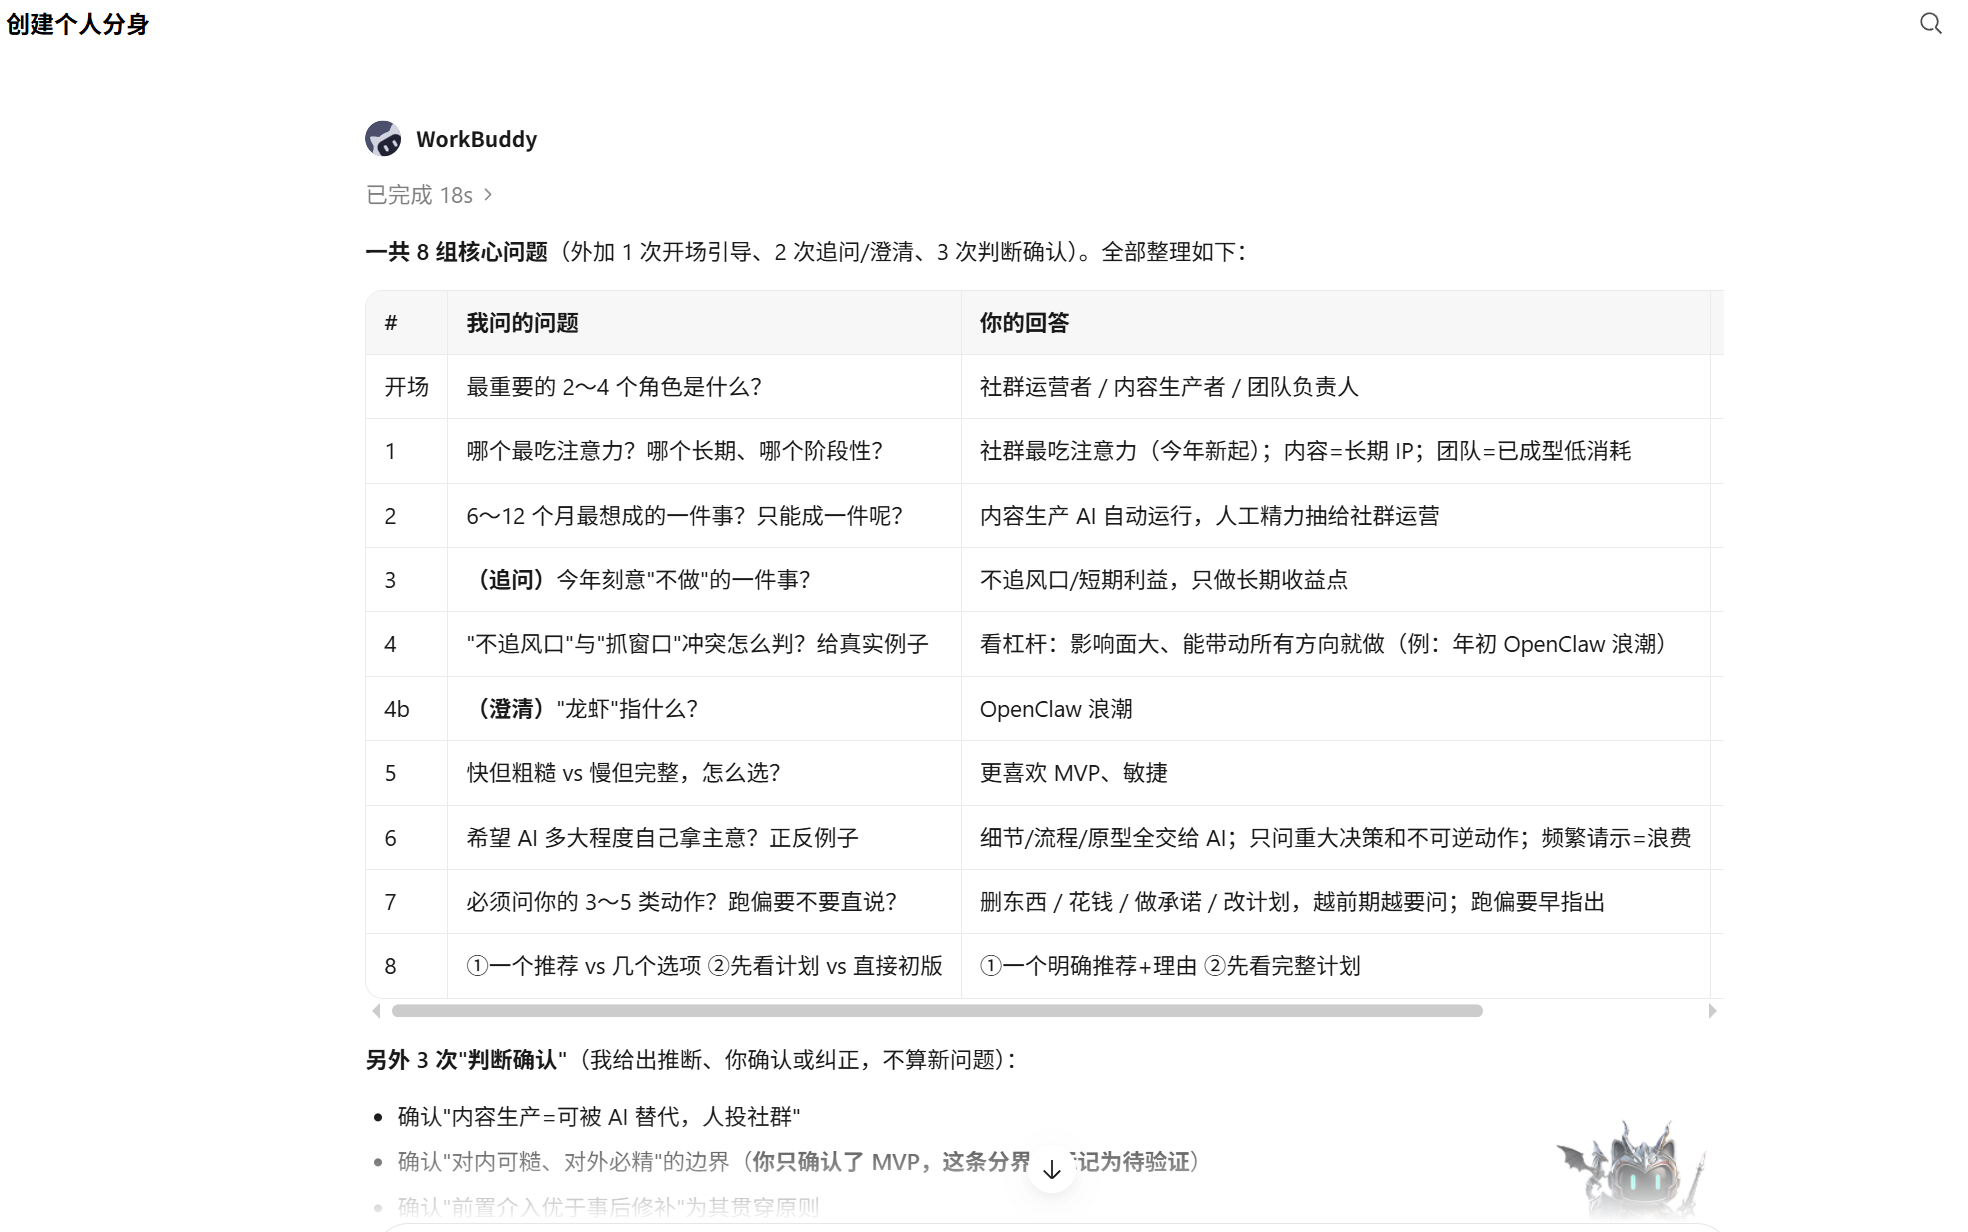
第二步,访谈。
这是访谈的整体情况。
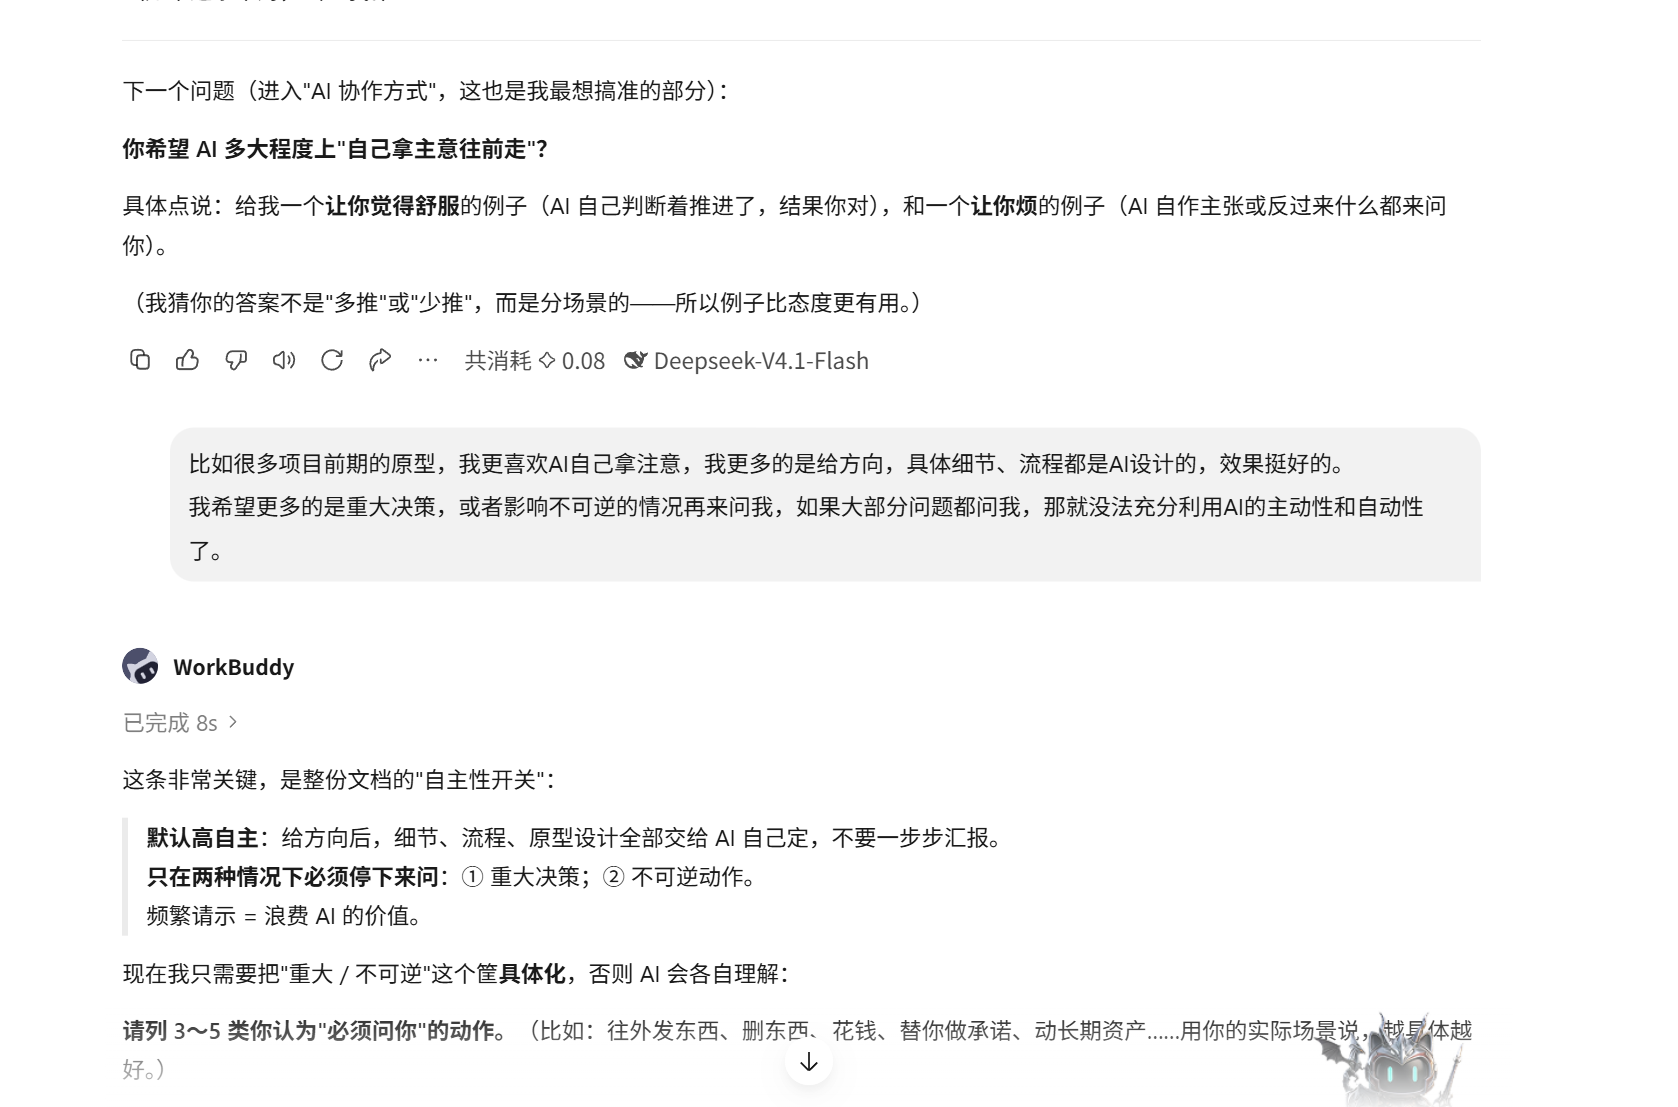
这是其中软件开发的一个访谈问题。
第三步,下载 Personal Twin Markdown 文档,等待使用。
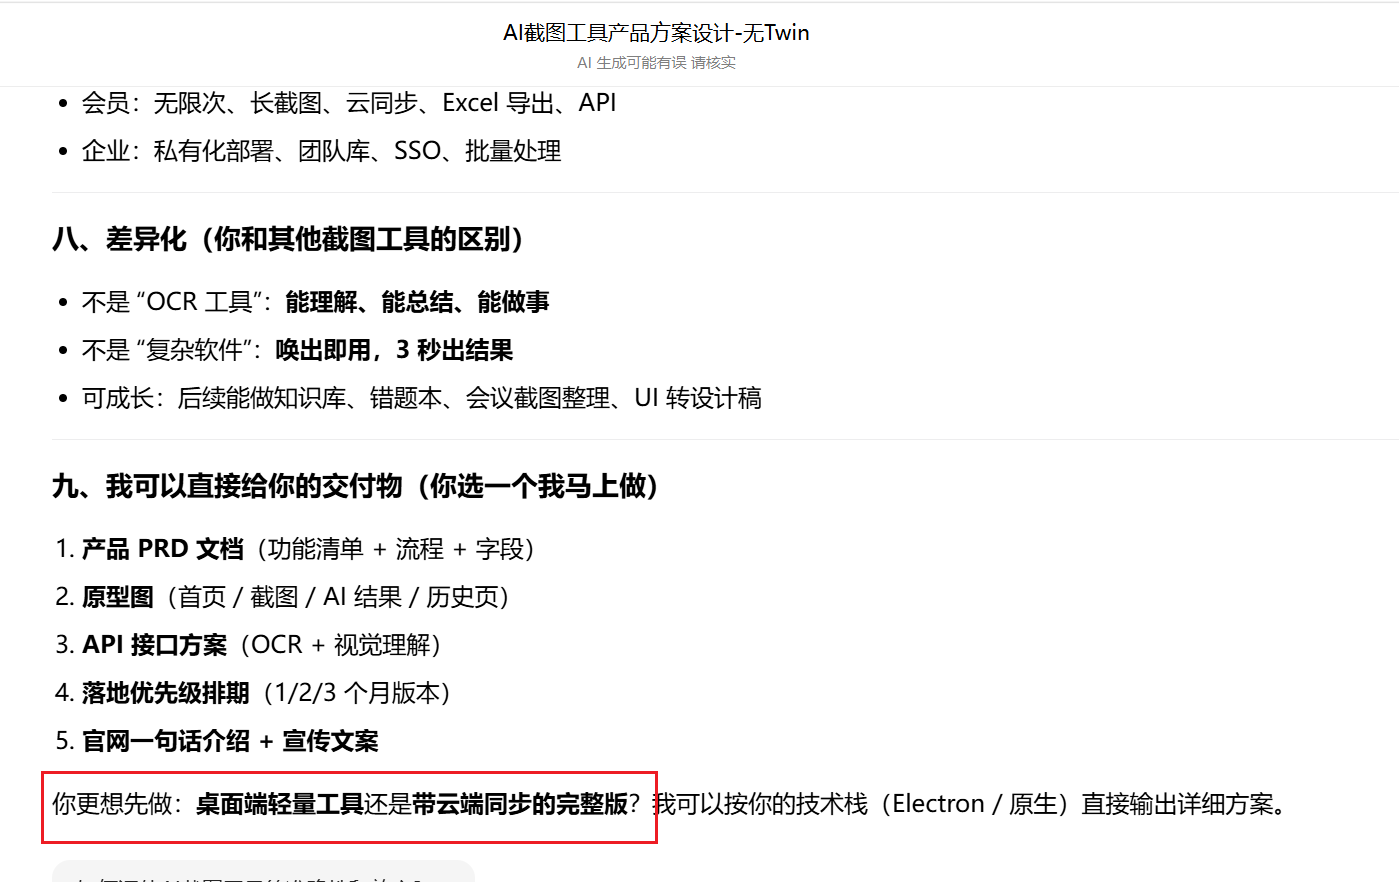
没有 Twin 的方案
首先,需要承认,没有 Personal Twin,AI 给出的方案其实已经比较完整了。
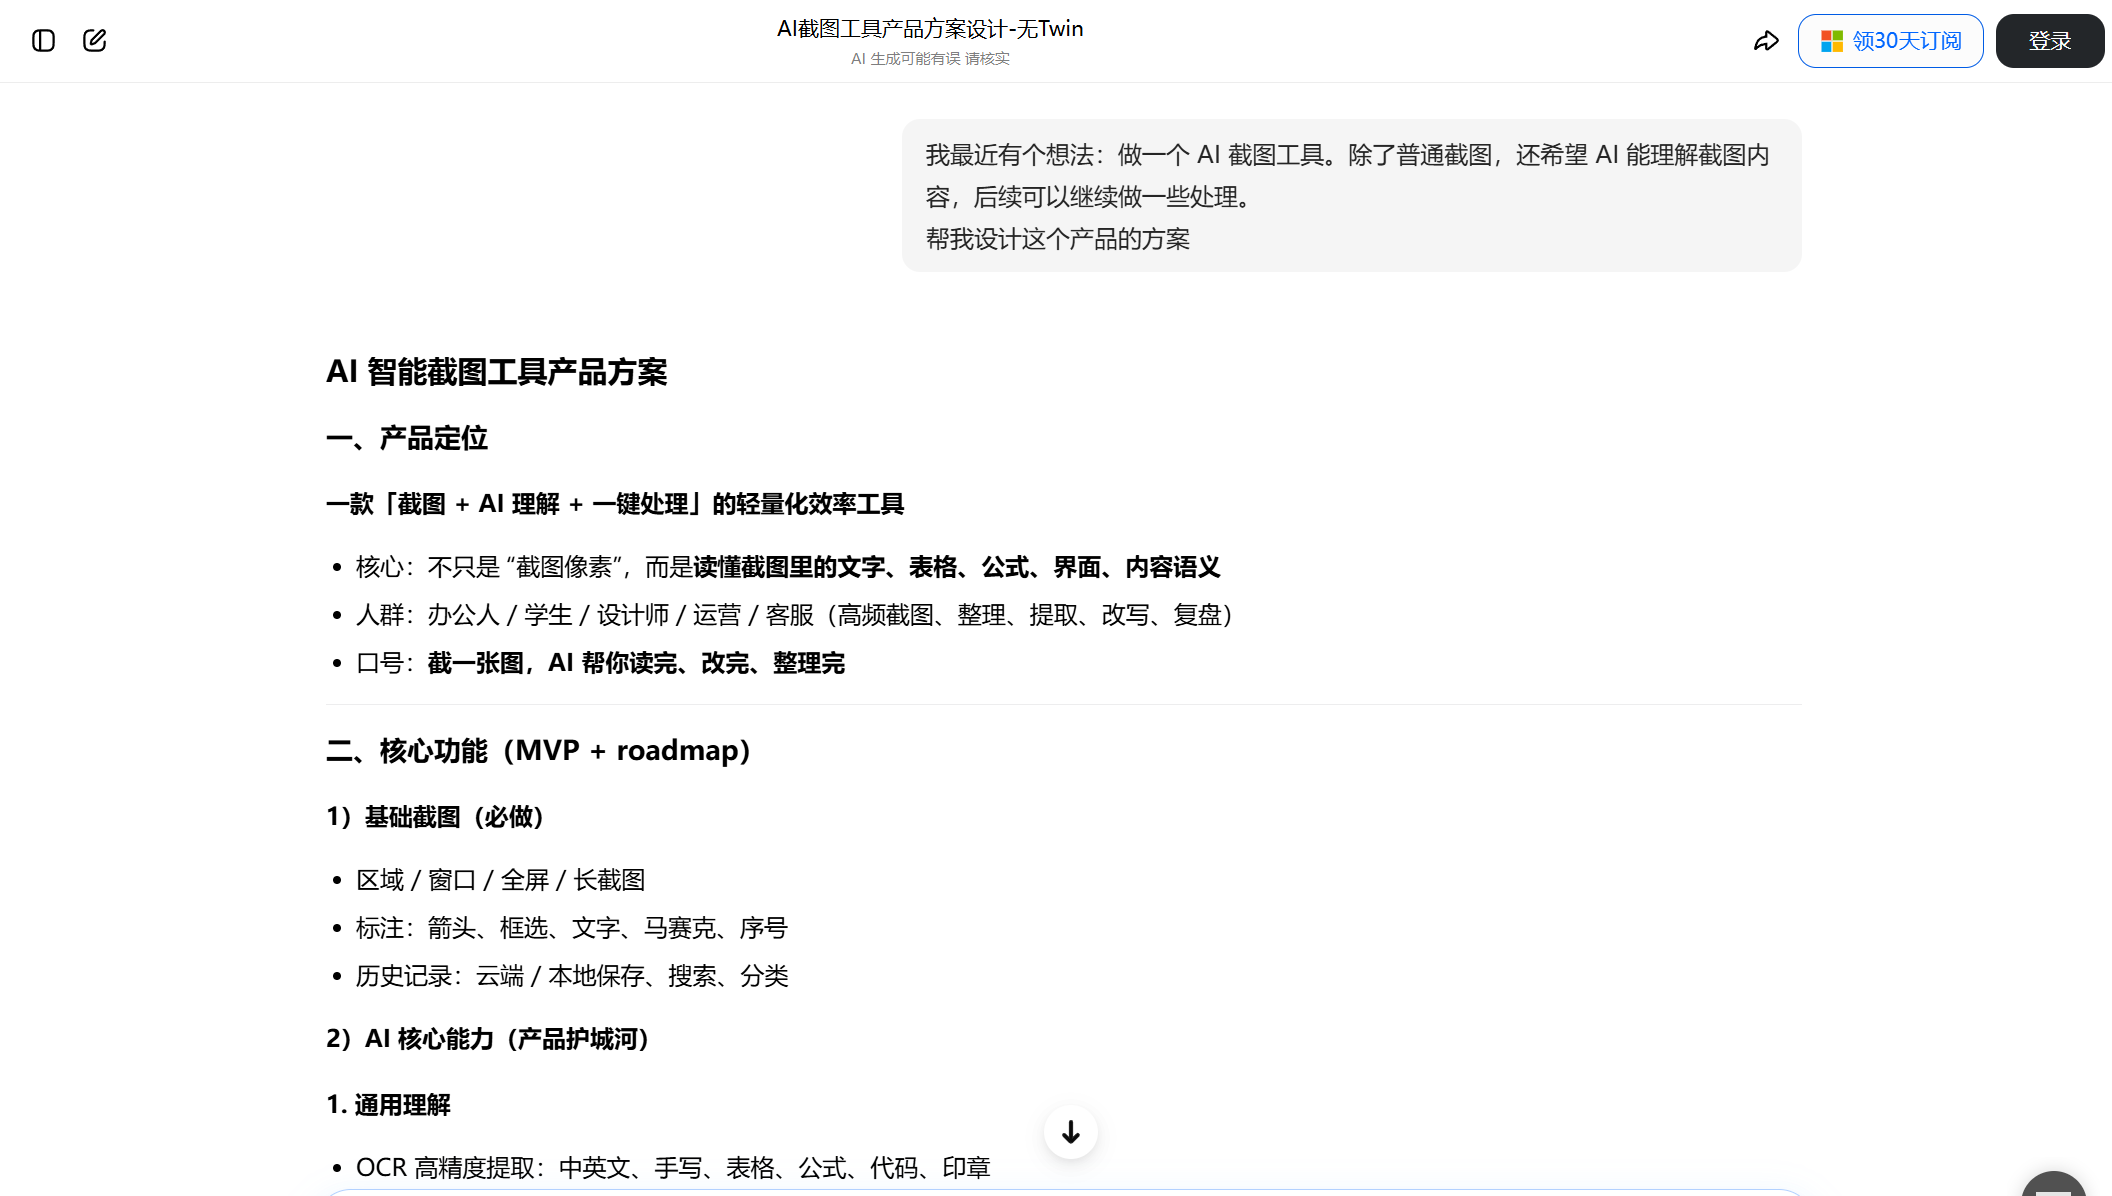
它自然想到:
- 截图;
- 标注;
- OCR;
- 图片理解;
- 表格识别;
- 代码分析;
- 总结;
- 历史管理;
- 导出。
并给出了一个典型产品方案:
截图 + AI 理解 + 内容处理。
从通用产品角度看,这个方案没有明显问题。
这也说明:
现在的大模型,本身已经具备很强的产品分析能力。
所以 Personal Twin 的价值,并不是让 AI 从不会做变成会做。
加入 Twin 的方案
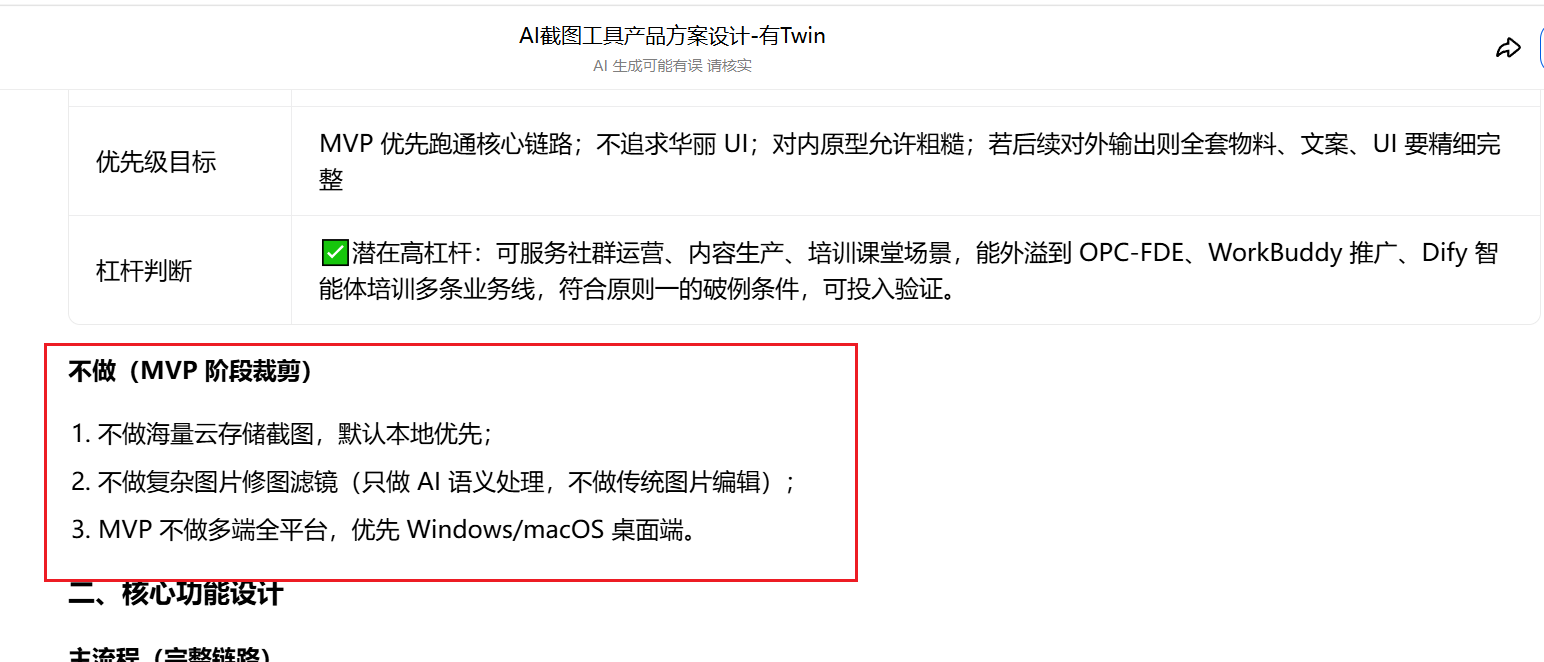
加入 personal-twin.md 后,最大的变化不是功能更多。
而是 AI 开始采用一些更接近我的判断方式。
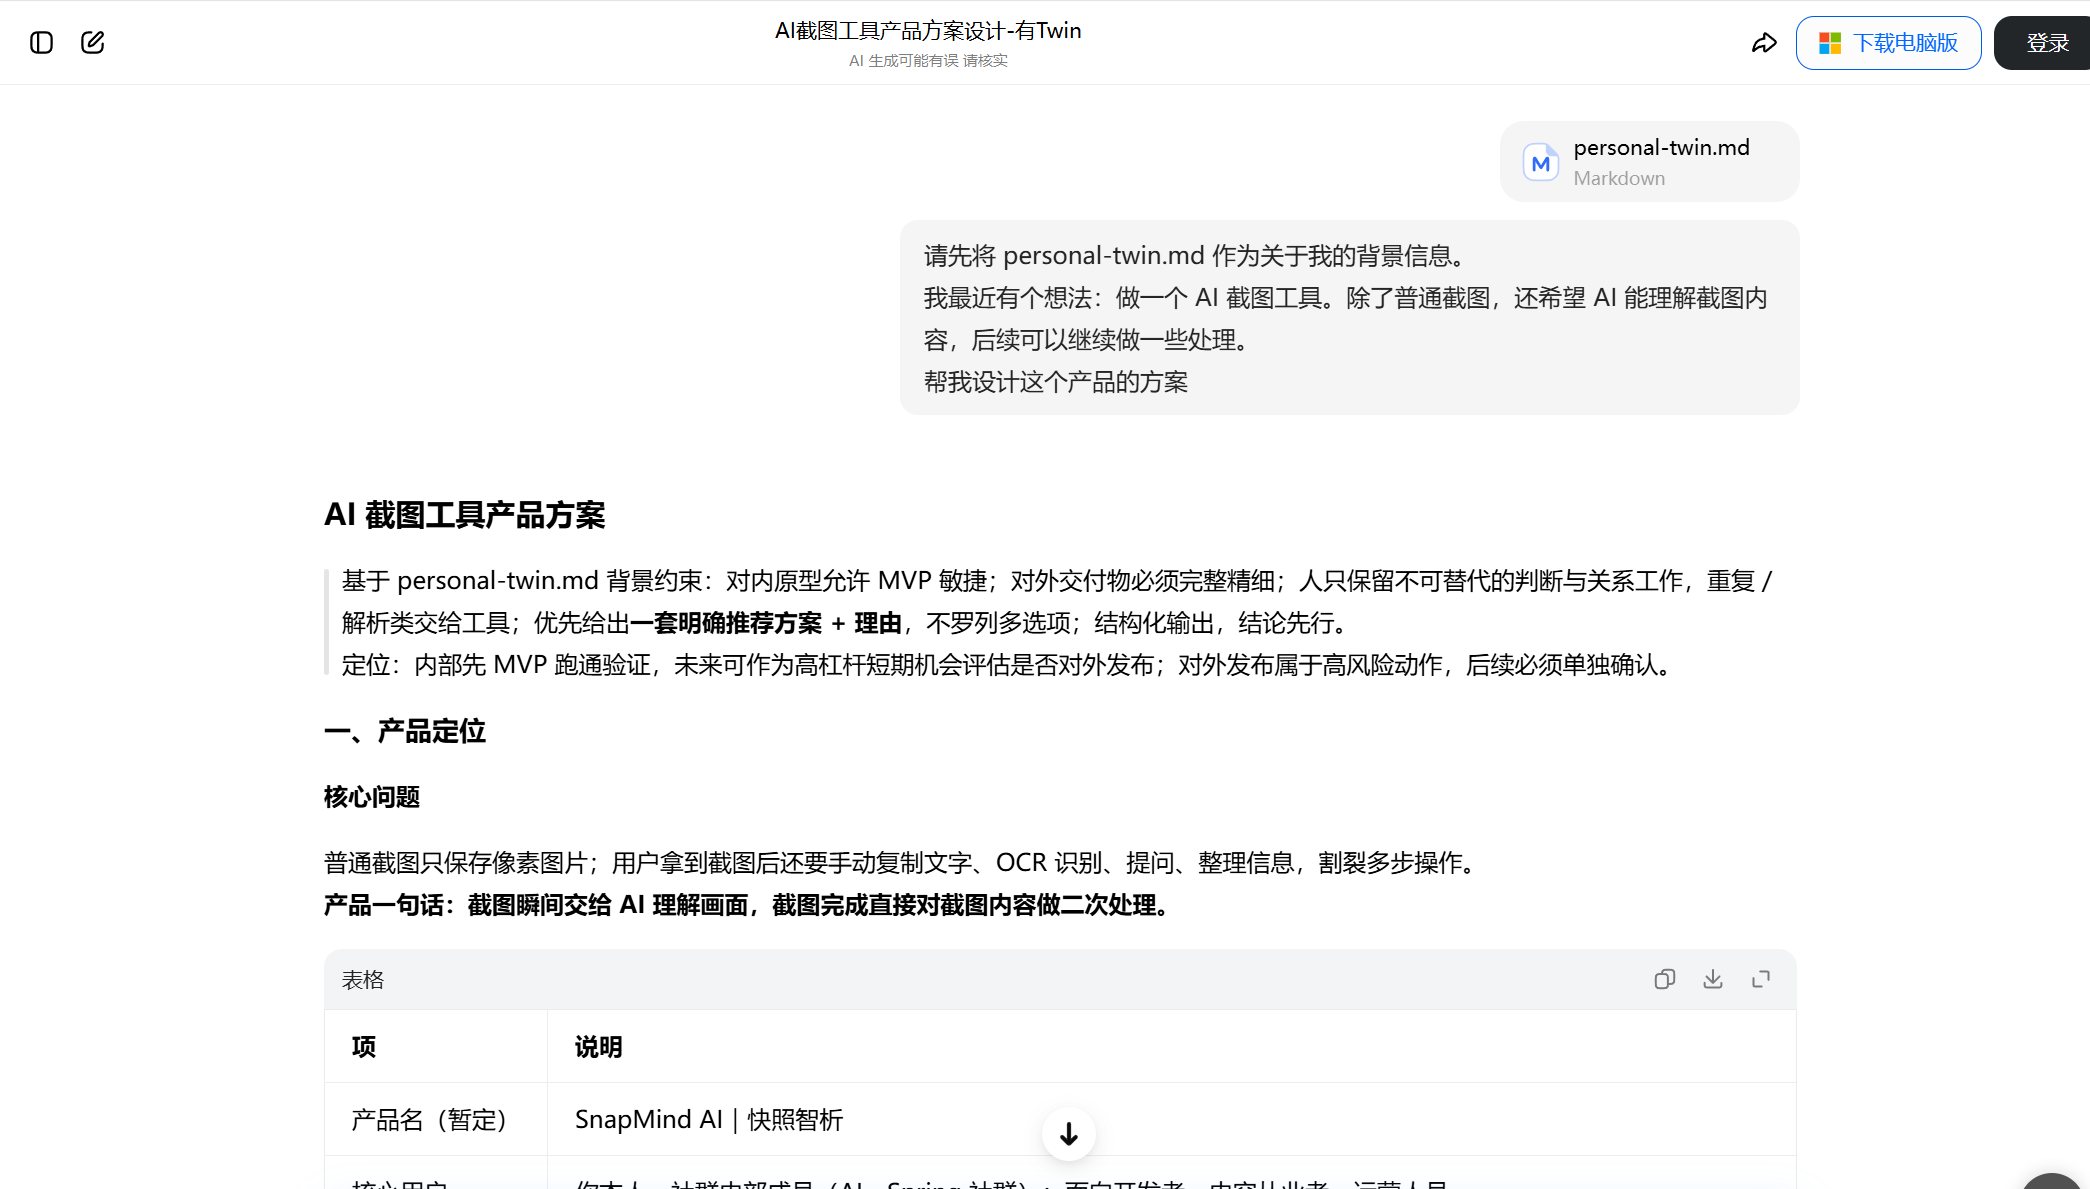
例如:
它没有再像之前让我判断“桌面端轻量工具还是带云端同步的完整版?”。
而是判断 MVP 更适合单一轻量桌面工具。
并且整体的技术方案也根据我的喜好,直接选择了更加适合 MVP 阶段的方案,而不是一个个询问我。
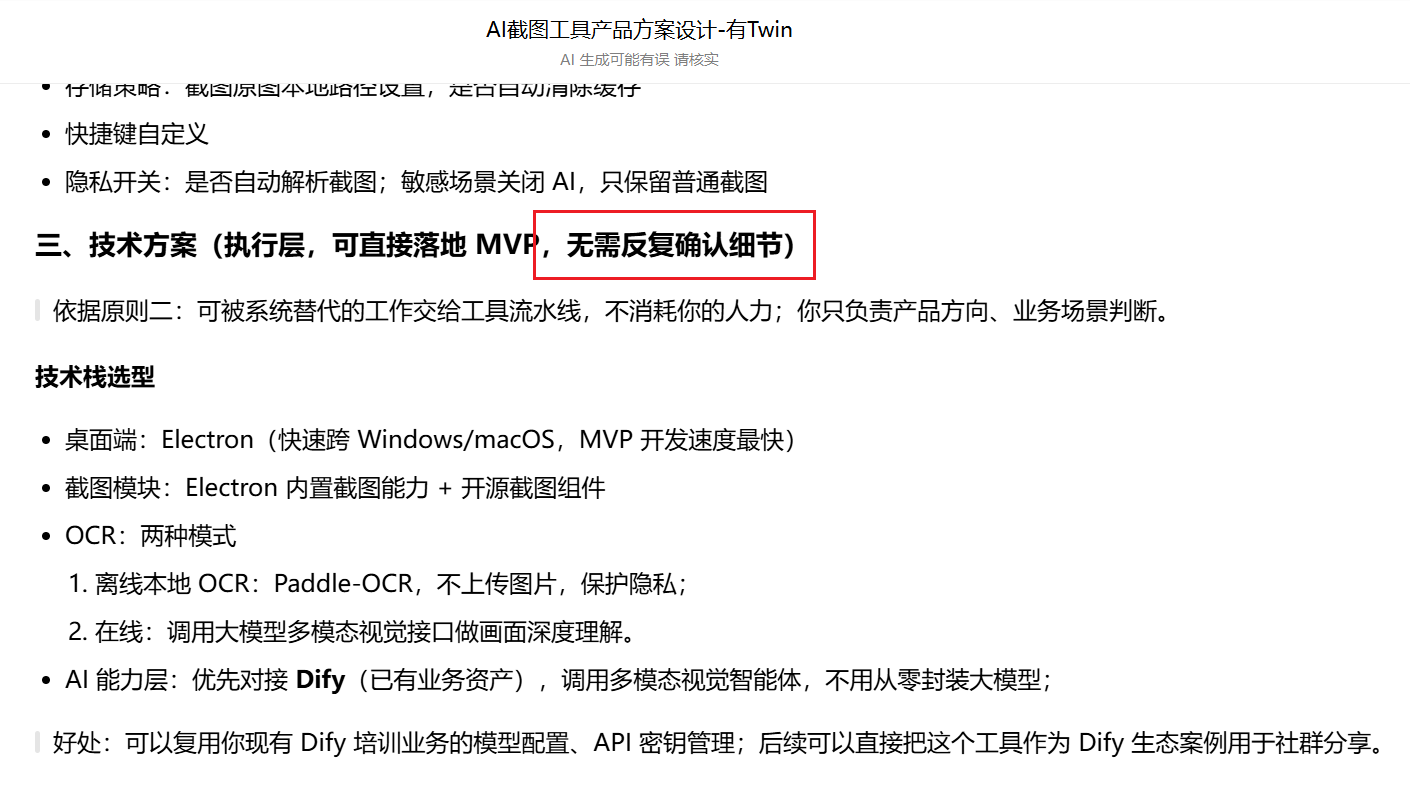
这说明:
Personal Twin 已经在影响 AI 做判断时参考的依据。
结语
总结下今天的文章重点:
- Personal Agent 的核心,不只是完成任务,而是开始理解“人”。
- Personal Twin 并不是 Memory 之外的新概念,而是一种通过结构化访谈,快速生成可用 Memory 初版的方法。
- 真正有价值的 Memory,不应该只是用户画像,而应该沉淀一个人的判断方式。
Personal Agent 已经火起来了,预期让大厂形成我们个人的各种“盗版”孪生,不如,自己搭建一套官方的 Personal Twin(个人孪生)。
如果你也感兴趣,可以下载本文 Skill 放入 Agent 直接尝试,也可以下载 Skill 源码修改后使用。
Skill git 地址: